2.3.1. Kỹ thuật ống dẫn lệnh (Instruction Pipelining)
Đặt vấn đề về cách xử lý lệnh truyền thống:
Ở các phần trước, chúng ta đã biết một lệnh máy thông thường phải trải qua nhiều công đoạn nối tiếp nhau: Tìm nạp lệnh (Fetch – IF) –> Giải mã lệnh (Decode – ID) –> Thực thi (Execute – EX) –> Ghi trả kết quả (Write Back – WB).
Trong các CPU thế hệ cũ không có kỹ thuật ống dẫn (xử lý tuần tự đơn thuần), CPU phải chờ câu lệnh thứ nhất hoàn tất trọn vẹn cả 4 công đoạn từ đầu đến cuối thì mới bắt đầu nạp câu lệnh thứ hai.
Nhược điểm của cách xử lý tuần tự: Rất lãng phí tài nguyên phần cứng. Ví dụ: Khi CPU đang làm giai đoạn Thực thi (ALU làm việc) thì bộ phận đọc lệnh từ bộ nhớ và bộ giải mã lệnh lại phải nằm im chờ đợi, không được sử dụng.
Để giải quyết sự lãng phí này, các kỹ sư máy tính đã đưa vào CPU kỹ thuật Ống dẫn lệnh (Instruction Pipelining).
2.3.1.1. Khái niệm và nguyên lý xử lý gối đầu các công đoạn của lệnh
Khái niệm kỹ thuật ống dẫn lệnh:
Ống dẫn lệnh (Pipelining) là kỹ thuật tổ chức phần cứng bên trong CPU cho phép nhiều câu lệnh cùng được xử lý đồng thời bằng cách chia nhỏ quá trình thực thi lệnh thành nhiều công đoạn (gọi là các tầng hoặc các chặng – stages) và cho các công đoạn này hoạt động song song, gối đầu lên nhau theo từng nhịp xung đồng hồ.
Ví dụ trực quan đời sống (Quy trình giặt ủi đồ):
Hãy hình dung một tiệm giặt ủi có 4 công đoạn riêng biệt: (1) Giặt –> (2) Sấy à (3) Ủi đồ –> (4) Gấp quần áo. Mỗi công đoạn đều mất đúng 30 phút.
Cách làm tuần tự cũ: Chờ mẻ đồ số 1 giặt xong, đem sấy, ủi rồi gấp gọn gàng (mất 2 tiếng) thì tiệm mới nhận giặt mẻ đồ số 2. Làm như vậy máy giặt sẽ bị bỏ không suốt 1 tiếng rưỡi khi đang ủi và gấp đồ.
Cách làm theo kiểu “ống dẫn” (Pipelining):
- Khi mẻ đồ số 1 chuyển sang máy Sấy, máy Giặt lập tức nhận mẻ đồ số 2 vào giặt ngay.
- Khi mẻ số 1 sang bàn Ủi, mẻ số 2 chuyển sang máy Sấy, thì mẻ số 3 lại được đưa vào máy Giặt.
- Sau khi dây chuyền đã đầy, cứ đều đặn mỗi 30 phút tiệm sẽ cho ra lò xong một mẻ đồ gấp gọn gàng.
CPU áp dụng kỹ thuật Pipelining cũng hoạt động theo đúng nguyên lý dây chuyền sản xuất công nghiệp này.
Nguyên lý xử lý gối đầu các công đoạn trong CPU:
- Khối xử lý lệnh được chia thành nhiều trạm làm việc độc lập (ví dụ mô hình 4 tầng: IF, ID, EX, WB).
- Giữa các tầng được ngăn cách bởi các thanh ghi đệm trung gian (Pipeline Registers) để lưu giữ kết quả của tầng trước chuyển sang cho tầng sau.
- Cứ mỗi nhịp xung nhịp (Clock cycle), mỗi tầng sẽ xử lý một phần công việc của một câu lệnh khác nhau:
Nhịp 1: Lệnh 1 vào tầng Nạp lệnh (IF).
Nhịp 2: Lệnh 1 chuyển sang Giải mã (ID); đồng thời tầng IF rảnh rỗi sẽ nạp ngay Lệnh 2.
Nhịp 3: Lệnh 1 sang Thực thi (EX); Lệnh 2 sang Giải mã (ID); Tầng IF tiếp tục nạp Lệnh 3.
Nhịp 4: Lệnh 1 sang Ghi kết quả (WB); Lệnh 2 sang EX; Lệnh 3 sang ID; Tầng IF nạp Lệnh 4.
Từ nhịp thứ 4 trở đi (khi đường ống đã được nạp đầy), cứ mỗi nhịp xung đồng hồ trôi qua sẽ có đúng một câu lệnh hoàn thành trọn vẹn.
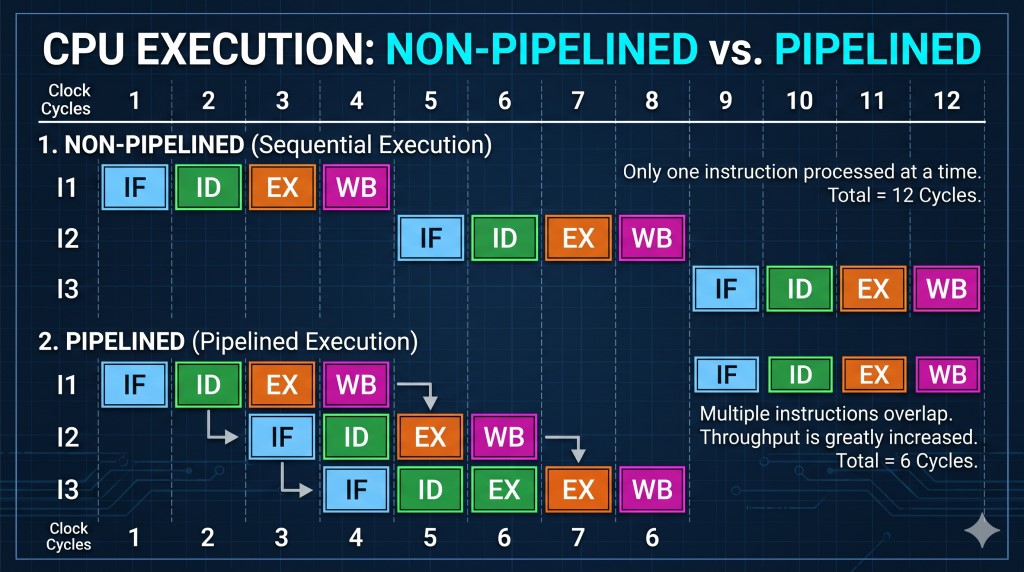
Giải thích
- Xử lý tuần tự – Non-Pipelined (Nửa trên sơ đồ):
- Cách thức: CPU xử lý từng lệnh độc lập từ đầu đến cuối; lệnh sau phải chờ lệnh trước hoàn thành xong cả 4 công đoạn (IF –> ID –> EX –> WB) mới được bắt đầu.
- Thời gian tiêu tốn: Để hoàn tất 3 câu lệnh, CPU cần tới 12 chu kỳ xung nhịp (Clock Cycles) (3 lệnh 4 công đoạn).
- Nhược điểm: Hiệu suất phần cứng bị lãng phí nghiêm trọng vì các khối mạch thường xuyên phải nằm im chờ đợi.
- Xử lý gối đầu – Pipelined (Nửa dưới sơ đồ):
- Cách thức: Các câu lệnh được nạp gối đầu nhau theo từng nhịp xung đồng hồ. Ngay khi Lệnh 1 chuyển sang giai đoạn Giải mã (ID), tầng Nạp lệnh (IF) rảnh rỗi sẽ đón ngay Lệnh 2 vào xử lý song song.
- Thời gian tiêu tốn: Cùng với 3 câu lệnh đó, kiến trúc Pipelining chỉ tiêu tốn 6 chu kỳ xung nhịp để hoàn thành toàn bộ.
- Ưu điểm vượt trội: Tiết kiệm được một nửa thời gian làm việc, tối ưu hóa công suất hoạt động liên tục của các khối mạch bên trong vi xử lý và nâng cao thông lượng xử lý lệnh tổng thể.
2.3.1.2. Lợi ích tăng tốc độ xử lý tổng thể của CPU
Tăng thông lượng xử lý lệnh (Instruction Throughput):
Kỹ thuật Pipelining không làm giảm thời gian thực tế để một lệnh đơn lẻ đi qua hết các công đoạn (một lệnh 4 tầng vẫn cần đủ 4 nhịp xung để xong từ đầu đến đuôi).
Tuy nhiên, kỹ thuật này làm tăng vượt bậc thông lượng tổng thể (số lượng câu lệnh hoàn thành xong tính trên một đơn vị thời gian). Thay vì phải đợi 4 nhịp mới xong một lệnh, giờ đây trong điều kiện lý tưởng, cứ sau mỗi 1 nhịp xung là có một lệnh mới được hoàn tất.
Tối ưu hóa chỉ số CPI (Đưa CPI lý tưởng tiệm cận mức 1):
Ở kiến trúc xử lý tuần tự cũ, chỉ số số chu kỳ xung nhịp để làm xong 1 lệnh (CPI – Clocks\ Per\ Instruction) thường bằng tổng số công đoạn (ví dụ CPI = 4).
Khi áp dụng ống dẫn lệnh hoàn chỉnh, một khi đường ống đã được nạp đầy dữ liệu, tốc độ hoàn tất lệnh đạt mức lý tưởng:
CPIlý tưởng xấp sỉ bằng 1Điều này đồng nghĩa với việc mỗi xung nhịp đồng hồ cho ra một kết quả lệnh, giúp hiệu năng tính toán tăng gấp nhiều lần mà không bắt buộc phải đẩy xung nhịp phần cứng lên mức nguy hiểm.
Khai thác tối đa công suất của các khối phần cứng:
Giúp các linh kiện bên trong CPU không bị bỏ phí thời gian rảnh rỗi.
Khối ALU, bộ giải mã lệnh, bộ đệm bus và các cổng thanh ghi đều được vận hành liên tục và đồng thời trong từng chu kỳ.
Nền tảng phát triển cho các kiến trúc vi xử lý hiện đại:
Kỹ thuật ống dẫn lệnh là nền tảng sống còn cho các bộ vi xử lý kiến trúc tập lệnh RISC (như ARM trên điện thoại, router mạng) cũng như các dòng chip CISC hiện đại của máy chủ và máy trạm (Intel Xeon, Core i, AMD).
Đây là bước đệm trực tiếp để các kỹ sư phát triển tiếp lên các kiến trúc cao hơn như Siêu ống dẫn (Superpipelining) và Siêu vô hướng (Superscalar).